香港apex服务器地点与多机房容灾部署的最佳实践
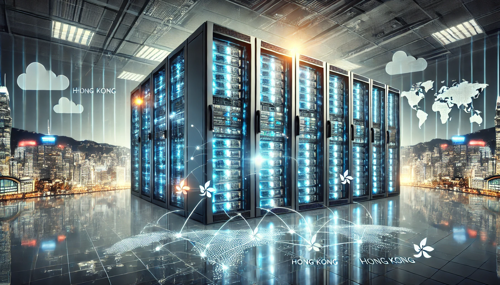
香港apex服务器地点与多机房容灾部署的核心要点
1. 精华:在香港选址优先考虑网络对等、低延迟与法律合规,apex服务器靠近主要出口可显著降低延时。
2. 精华:采用多机房容灾部署(异地热备+智能流量切换)能将RTO降至分钟级、将RPO压缩到秒级或分钟级。
3. 精华:结合负载均衡、Anycast/DNS故障转移和自动化演练,才能把纸面方案变成可落地的高可用体系。
作为一名在亚太有超过10年企业级网络与云架构经验的工程师(曾为金融与电商客户设计容灾方案),我在此给出一套可复制、符合法规并具备可测试性的多机房容灾部署最佳实践,帮助你在香港打造坚不可摧的apex服务器拓扑。
第一步,明确业务目标与指标:定义清晰的RTO与RPO,并据此选择热备、冷备或异地多活架构。金融类需求通常要求RTO<5分钟、RPO<1分钟;电商可在成本/可用性间折中。
第二步,选址策略要硬核:在香港选择机房时优先考虑运营商直连(Carrier-neutral)、低抖动链路与冗余出口。把核心apex服务器放在离主要ISP互联节点近的机房,次要节点部署在不同供电与地理微区的机房,降低单点故障风险。
第三步,网络与流量设计:采用多线BGP、Anycast+智能DNS和全局负载均衡组合。对延迟敏感的服务在本地优先响应,故障时通过健康检查触发自动切换。关键指标监控包含延迟、丢包、连接建立时间与带宽饱和度。
第四步,数据同步与一致性:根据业务选择同步或异步复制。强一致性数据库建议部署同步复制在同城多AZ并跨城异步容灾;日志与对象存储可用跨机房异步复制,结合定期一致性校验与自动回滚策略。
第五步,自动化与演练:用Terraform/Ansible自动化部署,用CI/CD触发容灾演练脚本。每季度进行全量切换演练,并记录时间线与失败点,调整Runbook,确保在真实事件中能按演练执行。
第六步,安全与合规:对接香港个人资料(PDPO)与行业监管要求,实施端到端加密、密钥管理与访问审计。在多机房中统一身份与权限管理,保证故障切换时不会放大权限风险。
第七步,监控、告警与容量规划:用Prometheus+Grafana或厂商SaaS监控链路、服务与数据库复制延迟,按SLA定义多级告警。容量预留要包含峰值放大(至少1.5倍)以应对切换瞬间流量抖动。
最后,成本与治理:评估多机房带来的网络与存储成本,采用分级存储策略压缩长期数据复制开销。建立治理委员会,定期评估技术债与合规风险,确保方案既强又可持续。
结论:将apex服务器部署在香港并实施多机房容灾部署不是一次项目而是长期工程,结合明确的RTO/RPO、网络冗余、自动化演练和合规控制,才能打造真正可用、可测、可审计的高可用平台。若需落地设计或演练脚本,我可以基于你的业务给出定制化实施清单与成本估算。
作者:资深云架构师,10年亚太容灾与网络优化实战经验,擅长跨机房高可用架构与自动化演练设计,致力于把理论转化为可复制的“硬核”生产方案。
-
对比多家服务商判断香港服务器哪个性价比高 的实战案例
在多家供应商的实际对比中,我们用统一的测试标准(价格、CPU/内存、带宽、丢包与延迟、SLA与售后)快速筛选出在稳定性与成本之间达到最好平衡的方案。本文以实测数据与可复现的方法,帮助你在购买香港服务器时判断真正的性价比高低。 多少家服务商参与了本次对比测试? 本次实战覆盖了国内外共计8家主流提供商,包含大型IDC与小众VPS提供商。每家在同一2026年5月18日 -
对比评测 cn2 香港空间 与传统香港主机的差异
1. 概述:CN2 香港空间与传统香港主机的核心差异 (1)CN2是电信骨干的优选路由,侧重于对中国大陆到香港的优化;传统主机多走普通国际/本地互联路线。 (2)CN2空间通常提供更低的延迟和更稳定的丢包率,而传统香港主机延迟波动较大。 (3)在带宽与计费上,CN2机房常提供1Gbps或更高专线口与95峰值计费选项;传统主机可能以共享口或固定2026年8月3日 -
亿云香港服务器带宽计费模式与成本控制方法揭秘
亿云香港服务器通常提供多种带宽计费模式以适应不同业务场景,常见包括按峰值带宽计费、按流量计费、包月(包年)固定带宽以及按需弹性计费。 此模式以计费周期内的峰值带宽或统计口径(如95th percentile)为准,对流量突发但平均不高的业务较友好。 适合视频直播、短时流量波动大但长期平均较低的业务。 需监控峰值频率,频繁峰值会使费用接近按量计费的不2026年5月14日 -
香港CN2测速 实战教程教你用工具判断线路质量
1.概述:为什么要做香港CN2线路测速 - CN2 是运营商的高质量骨干线路,适合对延迟敏感的服务。 - 测试可以判断是否走的是 CN2/GIA 路由或普通骨干。 - 对于香港 VPS/服务器,良好线路能把延迟从 100ms 降到 20–40ms。 - 与域名解析、CDN 配合,可改善访问稳定性与全球覆盖。 - 测试结果也影响 DDoS 防护策略2026年8月12日 -
案例研究香港cn2线路的优势为跨境电商带来的转换率提升
问题1:什么是香港CN2线路,它在网络层面的核心优势有哪些? 香港CN2线路是指经由中国电信CN2骨干网络并在香港落地的高品质国际出口链路。其在网络层面的核心优势包括:更低的延迟和更稳定的路由策略、较低的丢包率以及更好的带宽保障。CN2网络采用优先级路由、拥塞控制和更少的中转节点,能够减少跨境传输时的抖动与丢包,从而提升实时数据传输与网页资源加2026年9月5日 -
华为香港服务器 翻墙 合规风险与企业合规性审视报告
导言:最佳、最便宜与合规优先 在选择海外托管或云服务时,很多企业会对价格、性能与合规性进行权衡。本文以华为香港服务器为例,针对市场上“最好”“最便宜”与“最合规”的判断标准进行评测,特别聚焦于因跨境网络访问可能触及的翻墙行为所带来的合规风险,并为企业合规性提供实际可行的审视与治理建议。 产品与服务概述 华为香港服务器通常指华为云或其他托管环境2026年9月28日 -
企业部署香港服务器租用线路图与多线冗余设计的实现方法
在为企业选择香港服务器时,既要考虑延迟与访问速度以判断“最好”,又要考虑成本以判断“最便宜”。通常“最好”的方案是结合高质量机房、ISPs多样化和多线冗余设计来保证可用性与稳定性;而“最便宜”的方案常见为共享型VPS或低带宽云主机,但需牺牲带宽保证与抗攻击能力。本文将全面评测从基础线路到复杂冗余的实现方法,帮助企业在服务器租用时权衡性能、可靠性与成2026年8月24日 -
节省费用攻略 香港服务器配置价格表优化与采购流程说明
在跨境业务和面向中国内地用户的场景下,选择合适的香港服务器能兼顾速度与合规性。本文以节省费用为核心,说明香港服务器配置的价格优化思路、典型配置价格范围以及采购流程,涵盖VPS、云主机、域名、CDN和高防DDoS等相关技术与产品建议,便于企业或个人做出性价比高的决策。 首先明确需求:根据业务类型(静态网站、电商平台、游戏或API接口等)判断资源需2026年10月8日 -
如果香港的服务器可以备案吗如何与服务商沟通实现技术配合
1.香港服务器是否可以进行大陆ICP备案(结论与法律背景) 1) 结论:香港服务器本身不能在中国大陆进行ICP备案。ICP备案对象是位于中国大陆的用于对外提供互联网信息服务的主机和服务商。 2) 法律依据:工业和信息化部要求备案的服务器与域名须使用在中国大陆的托管或云服务节点才能完成备案流程。 3) 实务影响:如果网站使用香港机房但通过中国大陆2026年5月15日